MOSS-Image ComfyUI 上手:国产开源图像模型怎么跑(2026)
2026 年 10 月 16 日,做 MOSS 语言模型的那个 OpenMOSS 团队——复旦 NLP 实验室,联合上海创新研究院与 MOSI Intelligence——开源了 MOSS-Image:一个 5B 参数的文生图模型,权重 Apache-2.0,发布当天就支持 ComfyUI。值得为它腾一块显存的原因只有两条:图里的长文字,它渲染得接近最好的闭源模型;版式,它接受结构化 JSON,而不是让你写一段「希望它懂」的话。第一条是渐进式改进,第二条改变了「提示词」这个东西的定义。
一句话上手: 在 ComfyUI 里跑 MOSS-Image,打开 ComfyUI Manager 搜 MOSS-Image 装原生插件;或者直接用 Comfy-Org 打包好的单文件 checkpoint,走普通 checkpoint loader。出图选 SFT 权重,采样器保持 Flow-matching Euler、50 步、CFG 3、shift 5,负分支在第 22 层跳过。显存吃紧就把管线切成 Sequential 模式,或者把画布尺寸降下来。
想一站式体验对比全球顶级图像大模型? Oimi AI Studio Canvas 把 GPT Image 2.5、Nano Banana 2.1、Seedream 5.0 Pro 和 30+ 图像、视频模型放进同一个工作台——同一个提示词,各家并排出图,免费起步。先用它把版式试出来,比自己折腾环境快得多。
10 月 16 日发布了什么
| 发布日 | 2026 年 10 月 16 日 |
| 团队 | OpenMOSS(复旦大学 NLP 实验室、上海创新研究院、MOSI Intelligence) |
| 权重 | MOSS-Image-Base(底模)与 MOSS-Image-SFT(精调版) |
| 架构 | 5B 单流扩散 Transformer,冻结的 Qwen3.5-9B 文本编码器,FLUX.2 VAE |
| 提示词长度 | 最长 4K token |
| 版式输入 | 原生支持——带 bounding box 的结构化 JSON |
| 许可 | Apache 2.0(权重与推理代码;第三方组件另按各自条款) |
| 首发支持 | ComfyUI、SGLang、vLLM-Omni、Diffusers |
| 训练数据 | 约 30 亿张去重图像,刻意不做过滤 |
架构里有一个值得停一下的细节:文本编码器差不多是图像主干的两倍大。这不是凑巧。文字渲染和版式,先是「读懂」的问题,然后才是「画对」的问题;一个连长 caption 都解不动的主干,不可能把标题放到你要求的那个位置。
两个卖点,只有一个是真的新
版式是数据,不是描述
每个图像模型都接受「把标题放在左上角」。几乎没有几个真的这样理解。MOSS-Image 把同一件事收成了 JSON:一段场景 caption,加一个 items 列表,每项包含 label、描述、可选的要渲染的文字,以及一个 bounding box。
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue uppercase title centered at the top.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    },
    {
      "label": "object",
      "caption": "A flat blue mountain illustration in the lower center.",
      "bbox": [-192, -288, 384, 288]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
几乎所有人第一次都会弄错坐标约定,所以直接说清楚:bbox_format: "yxyx" 意思是 [y_min, x_min, y_max, x_max],而 abs_centralized 是从画布中心量起。在 1024×1024 的画布上,每个轴的取值范围是 −512 到 +512,x 向右递增,y 向下递增。从普通像素坐标换算,就是各自减去宽、高的一半。
这个结构才是真正的卖点。框可以由脚本生成,构图因此可复现、可批量——一套品牌模板,一千个变体都守同样的版式,而不是一千次开盲盒。编辑走同一套逻辑:改文字、移框,重渲染出来的结果是你能指定的。
文字渲染:大部分场景守得住
OpenMOSS 自己出了套基准 LongLongTextBench,理由是原来的 LongTextBench 在 120 字左右的目标上已经饱和。新集合每个目标平均 1,339.8 字,差不多是 11 倍。他们的表:
| 模型 | LongLongTextBench |
|---|---|
| GPT Image 2 | 99.0 |
| Nano Banana Pro | 96.6 |
| MOSS-Image | 96.3 |
| Qwen Image 3.0 Pro | 94.3 |
| Qwen Image 2512 | 64.9 |
| FLUX.2 | 11.8 |
诚实读法:96.3 是「你能下载到的模型里最高的」,不是「全局最高」,而且这套基准是团队自己出的、素材也是他们选的。上面还压着两个闭源系统。版式控制(7Bench)上,MOSS-Image 以 0.88 mIoU 领先所有被测模型,次优 0.44;在 RealLayoutArena 那组盲评的人类设计对比里,它总排名第二,如果把提示词拉平,它是排名第一的图像主干。
FLUX.2 那个数字才是重新定义这次发布的东西:长文字渲染在开源模型里不是「差一点点」,是「基本没解」。
在 ComfyUI 里跑起来
1. 装插件。 先把 ComfyUI 更新到最新版,打开 ComfyUI Manager,搜 MOSS-Image,安装。仓库里带的是原生插件;主仓库的集成还在推进,所以 Manager 这条路是目前受支持的走法。
2. 或者用单文件 checkpoint。 Comfy-Org 把 MOSS-Image-Base 打成了标准的单文件 diffusion checkpoint,走普通 checkpoint loader 就能载入,不需要自定义节点,也不需要转换步骤——和当年 FLUX、SD3.5、Qwen-Image 拿到的待遇一样。
3. 载入示例 workflow。 插件在 comfyui/moss-image/example_workflows/ 下带了 moss-image.json。从它开始改,不要从零连线;那个 layer-skip 的设置尤其容易漏。
4. 用这组采样参数。 Flow-matching Euler、50 步、CFG 3.0、shift 5、负分支在第 22 层跳过、负向提示词留空。这是 OpenMOSS 给共享 Diffusers 管线推荐的数值,在 ComfyUI 的图里同样适用。
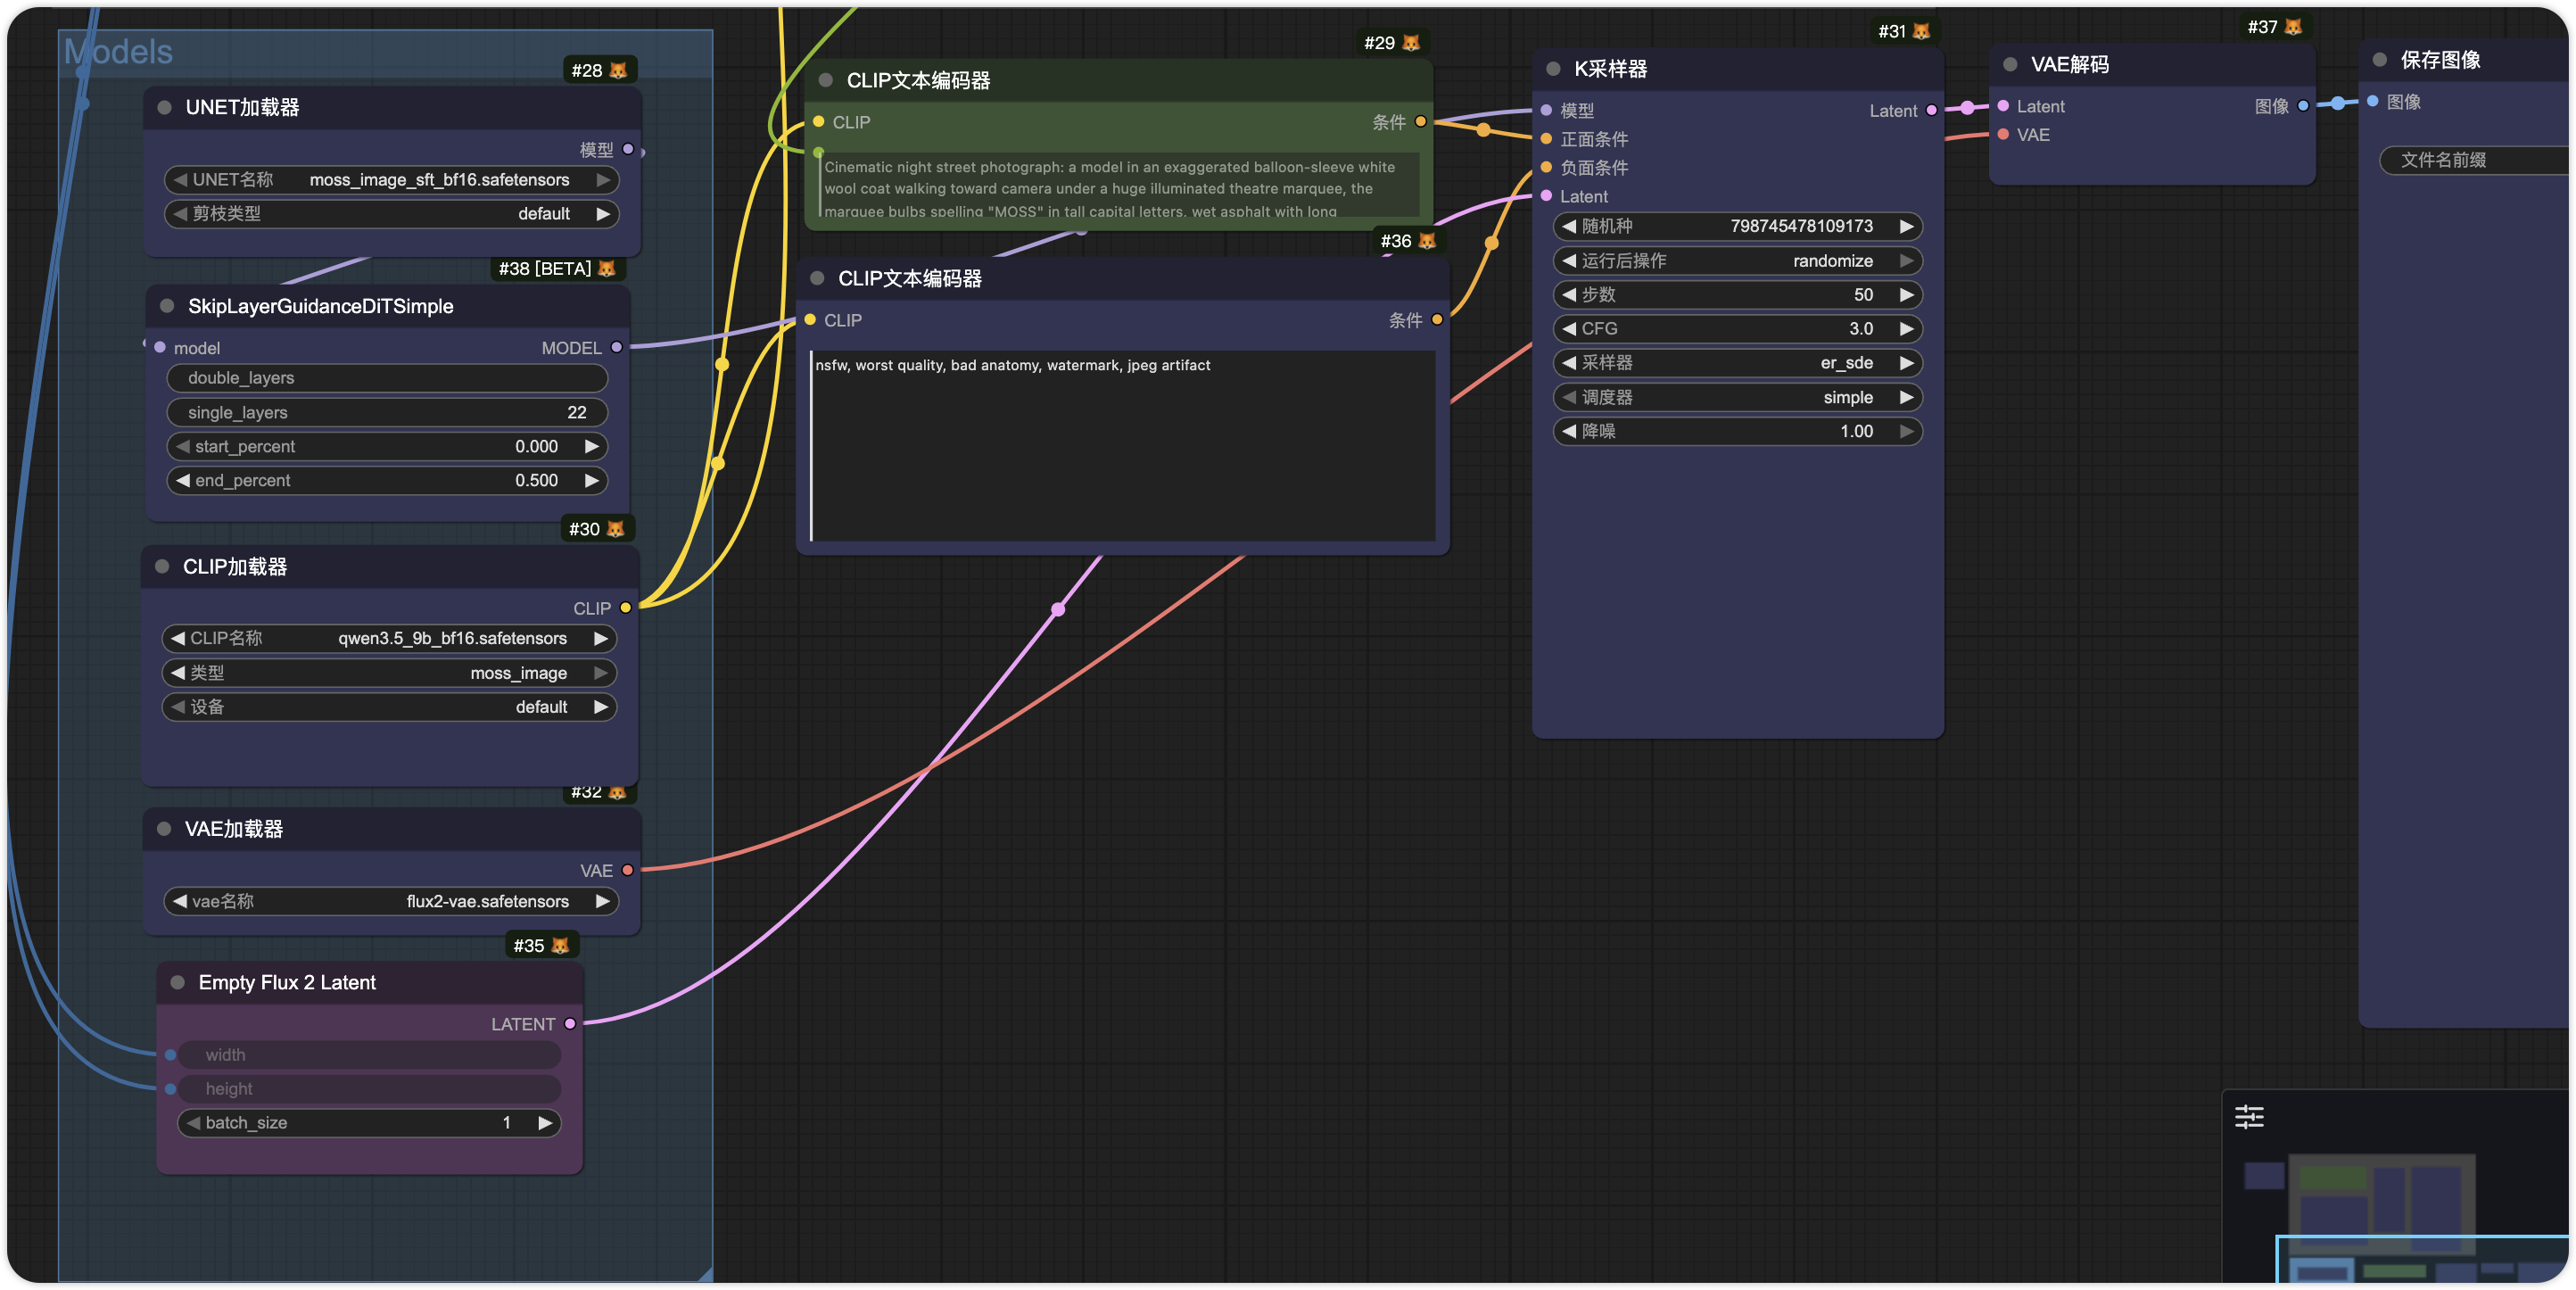
5. 选 Base 还是 SFT。 出图用 SFT——精调版的文字成组更紧、多元素版式更干净。Base 的存在意义是给你拿去训练的,不是因为它画的海报更漂亮。
6. 显存要提前算。 下载体积不等于显存占用。Base 仓库标注 27.2 GB,而 Comfy-Org 的打包是 48.6 GB,因为它塞了好几个变体和备选文本编码器——只取你要的那部分。OpenMOSS 没有公布最低显存要求,它给的是 GPU 常驻、Component、Sequential 三种内存模式,社区反馈是在 12GB 卡上用 Sequential 模式或者缩小画布能跑起来。
7. 想微调也可以。 DiffSynth-Studio 在 10 月 20 日,也就是发布后第四天,给两个权重都加上了全量微调和 LoRA 训练支持。
电脑配置一般,或者根本没碰过 ComfyUI? 上面这七步本身不难,难的全在环境上:节点装了不显示、workflow 载入报缺节点、显存不够中途重开、版本对不上报一堆红字。如果目的是把图像创意做出来,而不是把一套环境搭起来,那就别在这儿耗——直接去 Oimi AI Studio Canvas:不用装、不用配节点,30+ 图像与视频模型打开就能用,不占显存、不用等编译,免费起步。
第一周用户实测出来的东西
早期测试在强项和边界上出奇一致:
- 混排文字这一项能过。 英文海报按提示词拼写正确,中文竖排书法仍然可读,中英混排的两行都干净——这正是大多数模型翻车的场景。
- 带点推理的小要求也能过。 计数类请求(「三个苹果两个梨」)在社区测试里守住了,这算是判断模型是在读 caption 还是在套模板的一个不错的代理指标。
- 长篇古文还是断。 有位测试者要求一整首唐诗的水墨书法,试了几次都是掉句、丢标点。比之前任何开源模型都好,但不到可靠。
- 版式控制仍是实验性的。 坐标约定绊倒了一批首次使用者,社区文章也在劝:布局驱动生成暂时别放进生产管线。
为什么许可证是半个故事
图像模型一直带着摩擦交付。FLUX.1-dev 是非商用许可;SD3.5 系列用的是社区许可,过了收入门槛就需要单独谈;MOSS-Image 的权重是 Apache 2.0,把「我到底能不能用它做这个东西」的歧义消掉了——商业产品、托管服务、拿来卖的 LoRA、再分发一个蒸馏版,都在这条许可的射程内。
对一个小团队来说,这是「周末实验」和「能过法务」之间的差别。这也是为什么模型一天之内就出现在 ComfyUI 的 workflow 里:宽松许可加上 Comfy-Org 的官方打包,正是 Qwen-Image 在 2025 年跑通的那套增长剧本,而且这次又有效了。
还缺什么
- 一个 checkpoint 不等于整套系统。 5B 的图像 Transformer、9B 的文本编码器、加上 VAE,总得放进某个地方;目前流传的好几个「配置要求」把下载体积、选中文件、常驻内存混成了一件事。
- 遵守版式不等于保证版式。 JSON 指定的是意图。在每一个尺寸下模型是否尊重每一个框,正是生产测试要量的事,而目前没有人公布过这个测试。
- 基准是自家的。 96.3 和 0.88 都是设计测试的团队给出的强数字,独立评测还在形成中。
- 编辑还很早。 版式驱动的编辑是这个模型最有前途的方向,但社区的共识目前是「有希望,不能生产用」。
常见问题
MOSS-Image 是什么?
OpenMOSS 开源的文生图模型系列,团队是复旦体系下做 MOSS 语言模型的实验室。它是一个 5B 单流扩散 Transformer,冻结 Qwen3.5-9B 作为文本编码器;最有辨识度的能力是原生版式控制——除了普通提示词,它还接受一份描述物体、文字与 bounding box 的 JSON,并按这份规格渲染构图。
MOSS-Image 什么时候发布的?
2026 年 10 月 16 日,MOSS-Image-Base 与 MOSS-Image-SFT 两个权重随代码一起以 Apache 2.0 发布。ComfyUI、SGLang、vLLM-Omni 支持当天到位;技术报告在 10 月 19 日上了 arXiv,DiffSynth-Studio 的训练支持在 10 月 20 日跟进。
MOSS-Image 可以商用吗?
可以。权重与独立推理代码是 Apache 2.0,允许商业产品、托管服务、微调、出售 LoRA 与再分发,没有收入门槛,也不需要单独协议。少数第三方管线组件保留各自的许可,所以真正上线前仍要过一遍依赖清单——但模型本身是明确宽松的。
跑 MOSS-Image 需要多少显存?
OpenMOSS 没有公布最低数值。能确认的是:Base 仓库下载体积 27.2 GB,Comfy-Org 打包 48.6 GB(因为含多个变体),管线上提供 GPU 常驻、Component、Sequential 三种内存模式。社区在 12GB 卡上用 Sequential 模式或缩小画布跑通过。把那些下载体积当硬盘算,别当显存算,并且预期第一次运行会很慢。
MOSS-Image 和 GPT Image 2.5、Nano Banana 2.1、Seedream 5.0 Pro 比怎么样?
在团队自己的长文字基准上它拿 96.3,是所有可下载模型里最高的,但仍低于 GPT Image 2 的 99.0 和 Nano Banana Pro 的 96.6,而且这套测试由团队自己设计。它真正领先的是版式:7Bench 上 0.88 mIoU,次优 0.44。那两个闭源模型不接受 bounding box 规格作为输入,所以这一项上没有可比的数字可以并排放。Seedream 5.0 Pro 是同类型里最接近的一个——专攻密集排版与信息图——但它从提示词推断结构,不吃 JSON,所以公平的比法是同一条提示词各跑一遍,而不是看参数表。
这一步值得在下载 27GB 之前先做:Oimi AI Studio Canvas 里有 GPT Image 2.5、Nano Banana 2.1、Seedream 5.0 Pro 和 30+ 图像、视频模型,同一条提示词一次并排跑完,免费起步。需要可复现的版式、离线控制,或者一个能拿来微调的底模时,再把 MOSS-Image 装到本地。
延伸阅读
先看这两处,都是现成能用的:
想继续往下读,这几篇与本篇直接相关:
- AI 人像海报提示词:10 套看起来像美术指导过的设计(2026) —— 海报构图,正好是版式控制天生要解决的活
- 100+ 好用的 Nano Banana 提示词:复制即生成 —— 这次被追赶的那个闭源模型,以及说明为什么的提示词
- GPT Image 2 提示词 Top 20:人像、海报、UI 全覆盖,复制即用 —— 长文字基准上排第一的那家闭源模型,提示词怎么写
来源
- MOSS-Image in ComfyUI: Text-to-Image and Layout Workflows —— ComfyUI 官方教程,上面那张 workflow 的逐节点说明
- MOSS-Image · GitHub —— 权重、推理代码与示例 workflow 文件