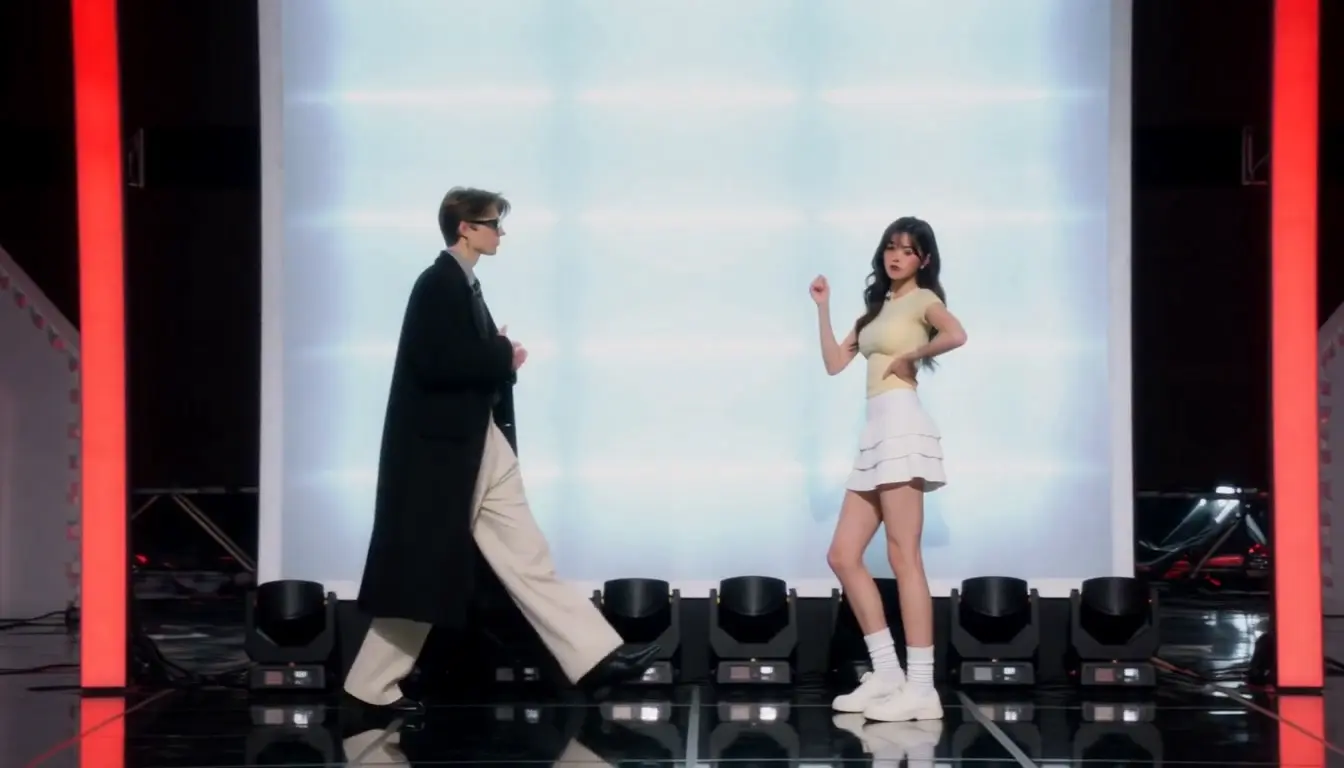
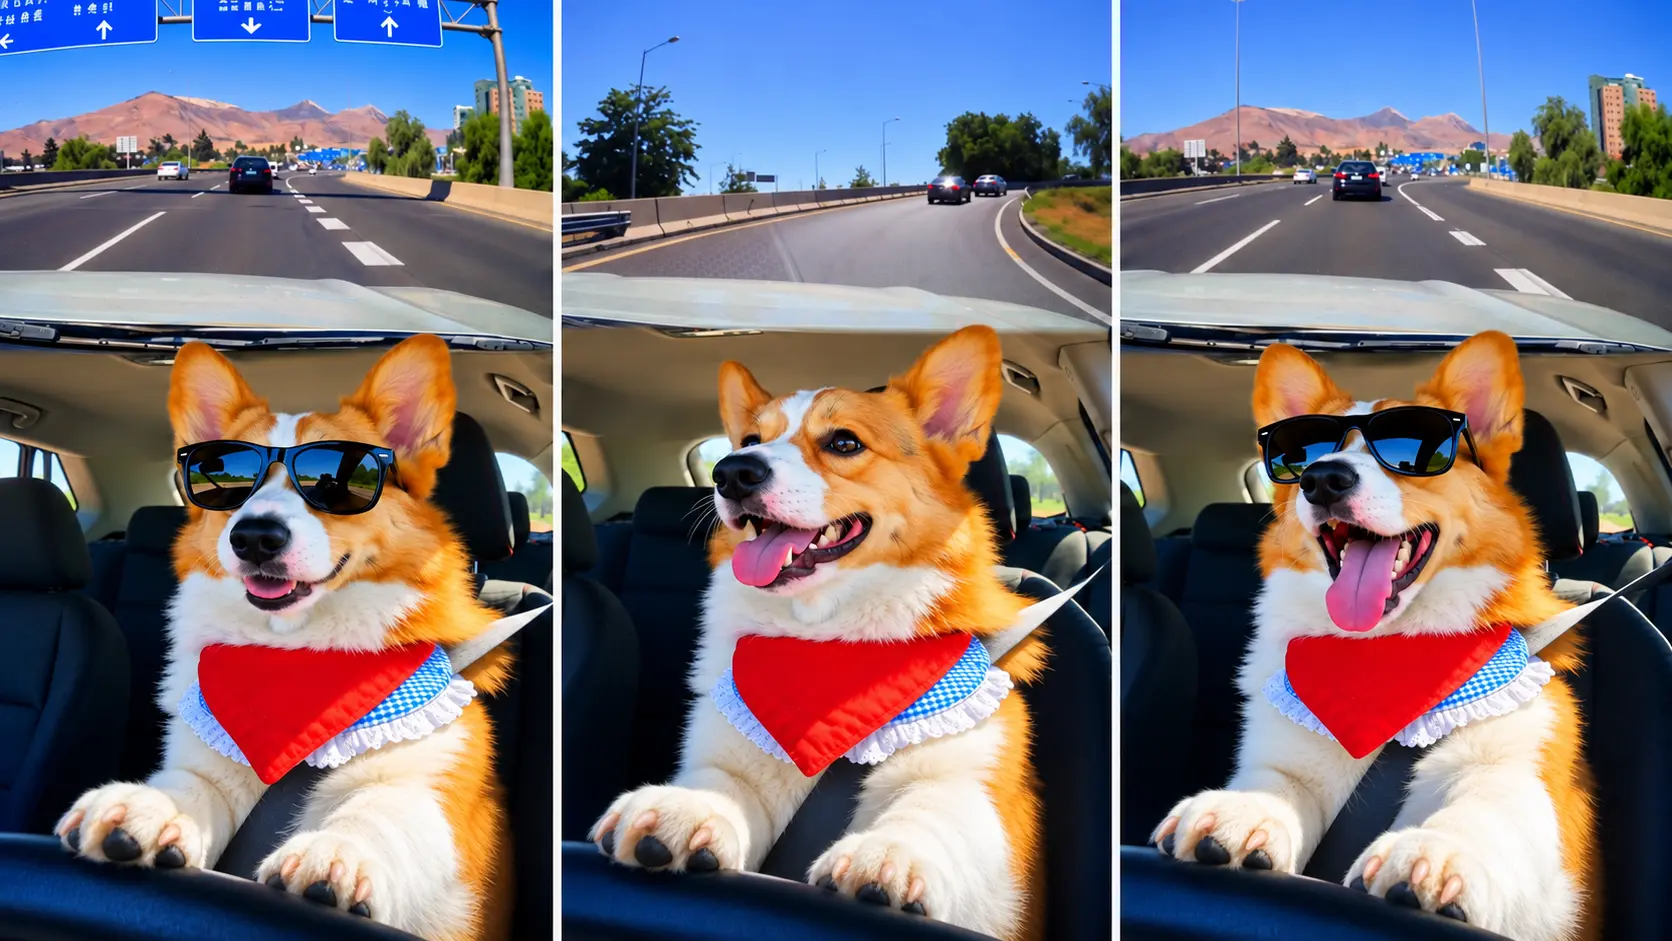
声音克隆开口说话照片 – AI 数字人对口型视频生成器
将人像照片或 AI 数字人形象与音频、中英双语声音克隆结合,生成最长 15 秒的对口型口播视频。两个模板为固定参数预设案例,如需自由组合与精细调整,可在PC端浏览器打开 AI 无限画布。
第 1 步:Generate AI Avatar
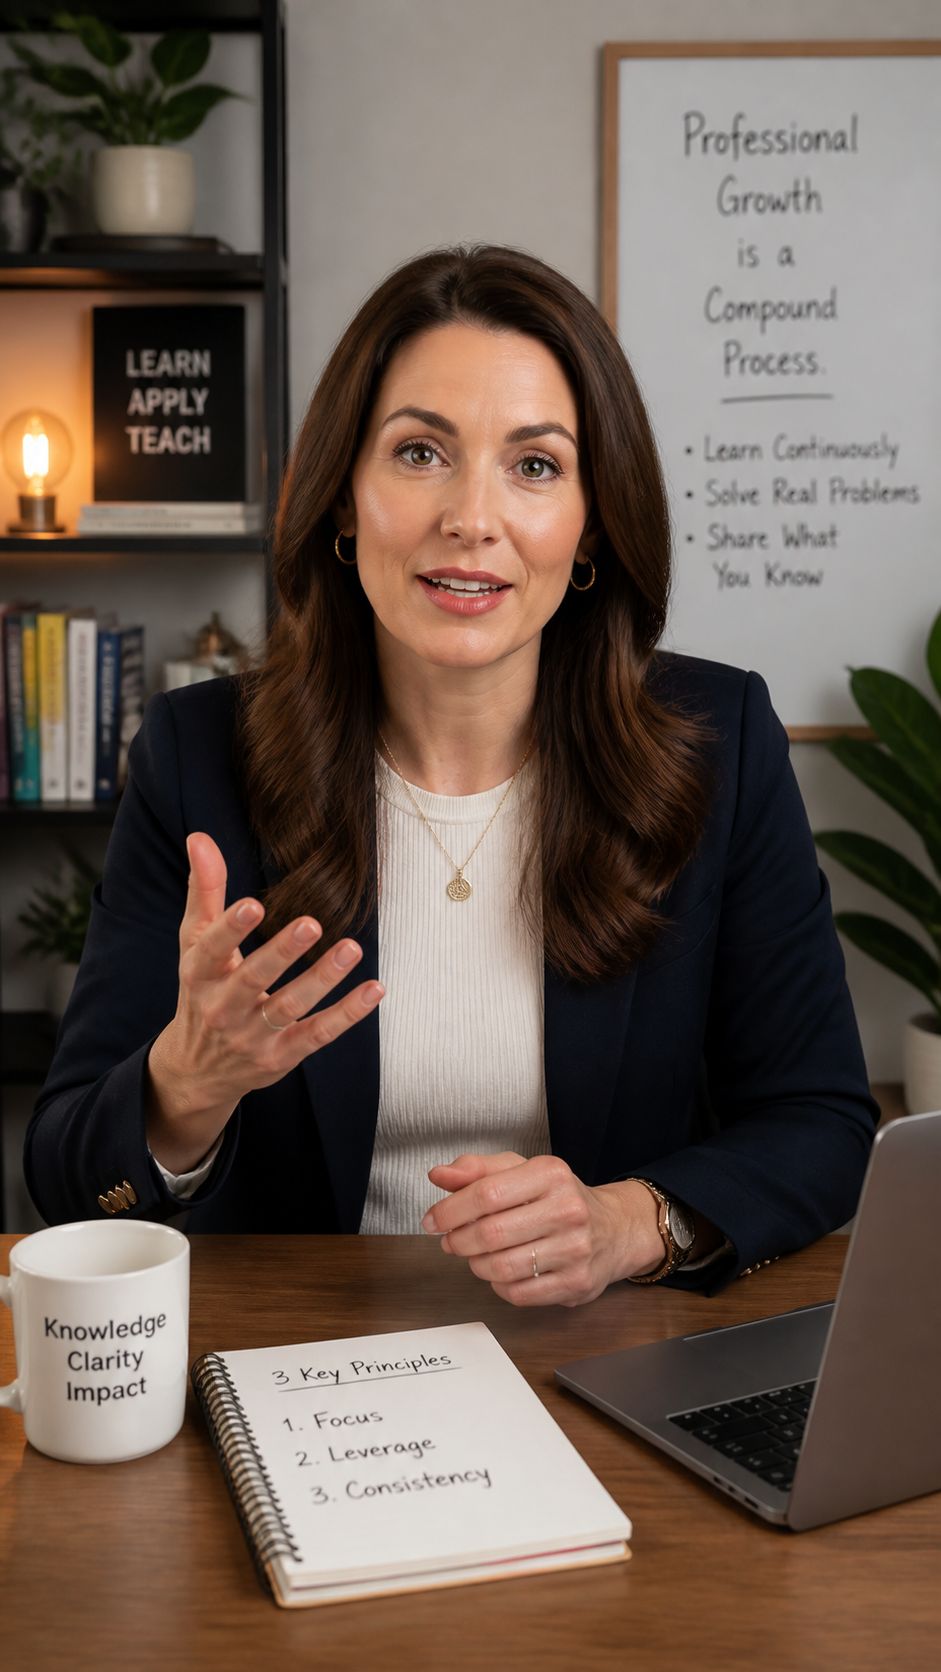
第 3 步:Generate AI Avatar Talking Video
生成期间,请勿关闭页面。如已关闭,可通过右上角的历史记录查看生成进度和结果。
为什么使用这个声音克隆与开口说话照片工作流?
预设模板快速测试(最长 15 秒)
你可以使用 模板 1:AI 数字人 + 音频(预设)(AI 生成数字人形象 + 音频生成视频)或 模板 2:自定义形象 + 中英声音克隆(预设)(上传数字人形象 + 参考音频 + 口播文案 + 中英声音克隆生成视频)作为现成起点。两个模板均为固定参数预设案例,生成视频最长 15 秒。
能力灵活组合:AI 生成或上传形象
你可以用 AI 生成数字人形象,也可以直接上传自己的人像照片作为画面主体——根据需要打造全新数字人设或保持固定形象,灵活组合输入素材。
直接上传音频或中英双语声音克隆
你可以直接上传现有音频文件,也可以通过参考音频与口播文案进行中英双语(ZH/EN)声音克隆,生成自然贴合的对口型说话视频。
电脑端 AI 无限画布深度自定义
页面预设模板采用固定参数,适合快速体验与出片。如果你需要自由组合节点、修改参数或进行更复杂的自定义创作,可在电脑端打开 AI 无限画布 灵活调整。
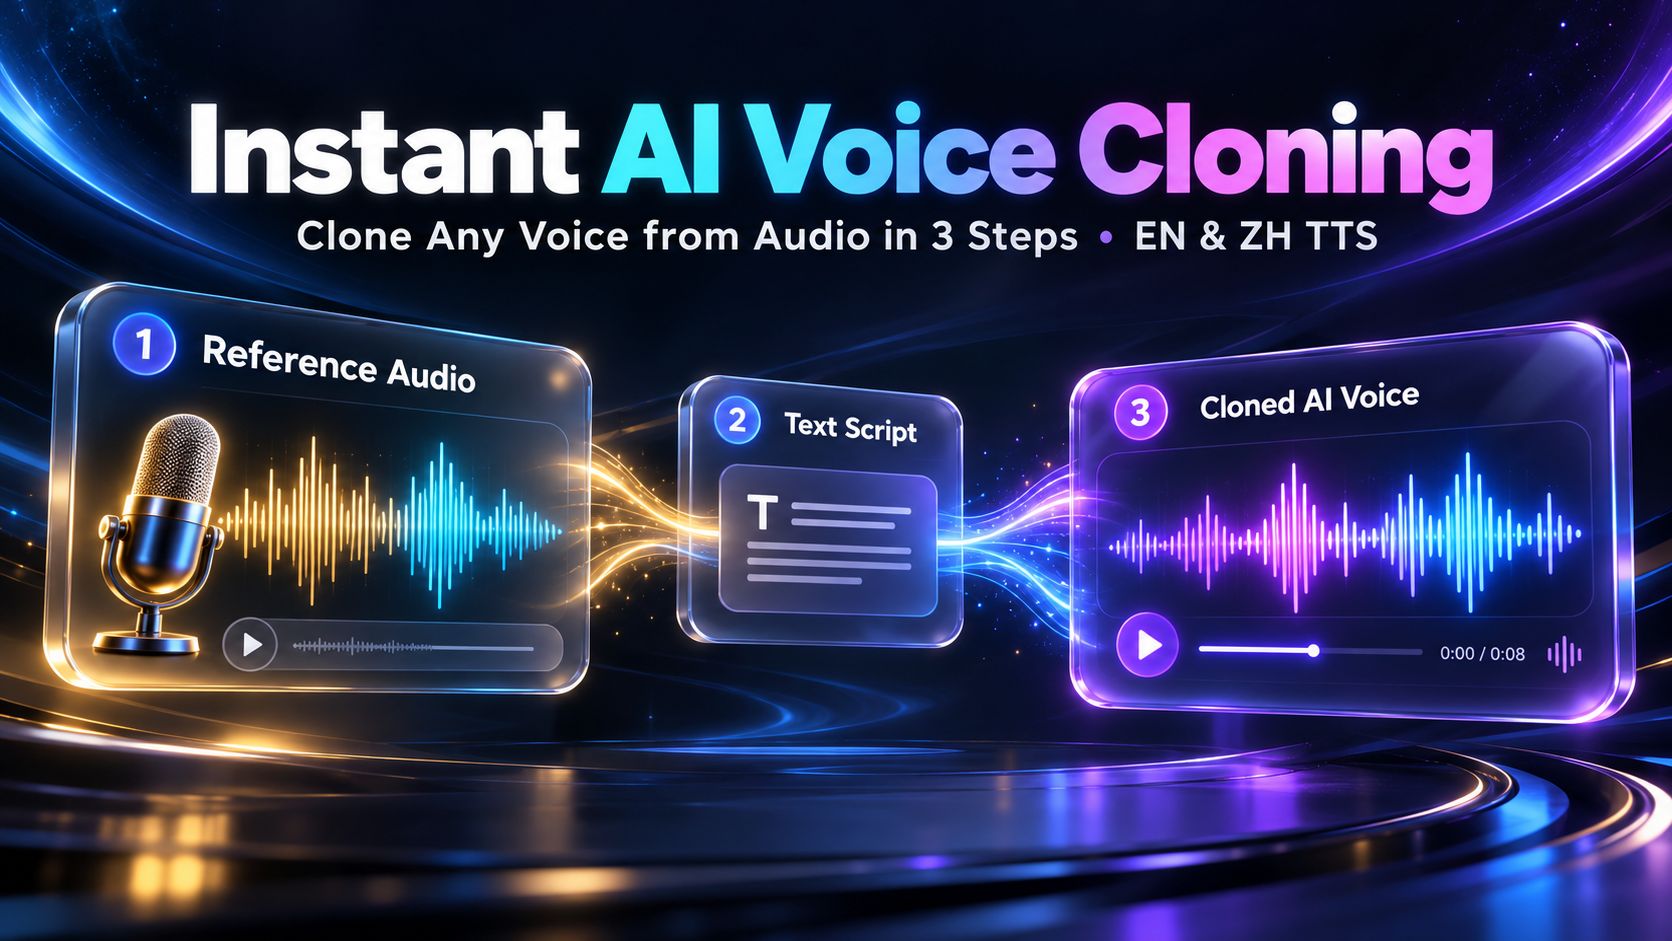
3 步生成开口说话视频
第 1 步:选择或上传数字人形象
通过 AI 生成角色形象,或直接上传你的人像照片作为视频画面基础。
第 2 步:添加音频或进行中英声音克隆
直接上传音频文件,或提供参考音频与口播文案,生成中文或英文克隆语音。
第 3 步:生成说话视频(最长 15 秒)
运行预设模板生成最长 15 秒的对口型视频;如需更多参数与组合调整,可在电脑端打开 AI 无限画布。
适用场景
短视频与无出镜口播创作
快速测试开头钩子、配音方向与数字人视觉概念,适合制作最长 15 秒的短视频片段,再在 AI 无限画布 中进一步扩展。
中英双语内容与跨语种传播
借助中英双语声音克隆与音频组合能力,复用形象与脚本思路完成中英文口播适配,无需从零重录。
产品展示、讲解片段与方案演示
将静态形象与配音转化为直观的口播演示视频,用于营销预览、轻量化讲解或创意方案展示。
常见问题(FAQ)
页面上的两个模板可以直接自定义参数吗?
不可以。这两个模板属于固定参数的预设展示案例,生成视频最长为 15 秒。如需自由组合步骤、修改参数或自定义流程,请在电脑端打开 AI 无限画布。
形象和音频方式可以自由混搭组合吗?
可以。你既可以使用 AI 生成形象或上传人像照片,也可以选择直接上传音频或使用中英双语声音克隆,按实际需求灵活组合。
声音克隆支持哪些语言?
支持中文和英文(ZH/EN)声音克隆,可结合参考音频与口播文案生成克隆语音并驱动对口型视频。
生成的视频最长是多少秒?
通过当前预设模板工作流生成的视频最长为 15 秒;如需更灵活的组合与深度自定义,请在电脑端使用 AI 无限画布。
开启更自由的创作
在 AI 无限画布中查看完整工作流、提示词和模型,让 Agent 协助完成更多创意。