
ChatGPT Images 2.5 (GPT-Image-2.5) 发布: 更快、更清晰、更智能
By Chris Morgan · 更新于 2026 年 9 月 9 日 · 6 分钟阅读
OpenAI 正式发布 ChatGPT Images 2.5——这是自 2026 年 4 月 Images 2 上线以来的首次重大更新。核心卖点很直接:图像生成最多提速 50%,细节更锐利、光照更自然,并带来一整套新的编辑工具,让你能精准修改想要改的部分,而不破坏其余内容。
新模型今天起面向所有 ChatGPT、ChatGPT Work 和 Codex 用户推送,覆盖桌面端、移动端和网页端。
同时为开发者上线两个新的 API 模型:GPT-Image-2.5 Flare 和 GPT-Image-2.5 Sunburst。当前 GPT-Image-2.5 Sunburst 已同步上线Oimi AI Studio无限画布,打开就能免费体验。
以下是 GPT Image 2.5 的完整升级解读。
ChatGPT Images 2.5 新特性
1. 生成速度最多提升 50%
最直观的变化是速度。OpenAI 表示,Images 2.5 相比上一代把生成延迟最多降低了 50%——当你需要批量跑几十个变体、或做高吞吐量生产时,这一点至关重要。「灵感 → 出图 → 微调 → 再出图」的循环,现在几乎没有了等待的卡顿感。
2. 细节更锐利、光照更自然、纹理更丰富
画质全面升级,新模型带来了:
- 更锐利的细节与更干净的边缘
- 更自然的光照与阴影
- 更丰富的纹理,皮肤、布料、表面质感更真实
3. 参考图保真度更高
当你上传参考照片时,Images 2.5 能在全新的场景、风格和构图中保持主体可识别。标志性特征更稳定地延续——这对品牌物料和角色类内容来说是巨大的提升。
4. 评论式编辑(只改你想改的地方)
这是最亮眼的生产力功能。你现在可以直接在图片上添加评论标注——点选某个区域,输入类似「删除这个区域」或「把这个改成蓝色」的指令,模型就只修改那一处,其余部分原样保留。
5. 多轮编辑一致性
在较长的对话里,之前的修改会被保留下来。每一次新的编辑都建立在已有结果之上,而不是让图片逐渐劣化——所以产品图、角色、广告素材在经过多轮修改后依然保持一致。
新工具:Sketch 和 Templates
Sketch——不会描述,就画出来
有些想法,画出来比描述出来更容易。Sketch 让你直接在 ChatGPT 里手绘草图作为视觉参考——输入 @ Sketch(或 @Sketch)即可调用,再补充风格或细节描述,让模型把你的草稿变成完整图像。
这尤其适合构图:你可以先草草画出主体、物体或版式的位置,再用文字指定风格。
Templates——从成熟格式开始
如果你有想法但不知从何下手,Templates 提供了海报、传单、产品图、周边商品等热门图像格式的现成模板。选一个模板,加上你的文案、设计元素或风格,就能做出自己的版本。
提示词分享
现在你可以把图片连同它原来的提示词一起分享出去,让别人用他们自己的照片来 remix 你的创意——这是对协作式、社交化创作的一个小而实用的补充。
两个新的 API 模型:Flare vs Sunburst
开发者拿到两个新端点,各司其职:
GPT-Image-2.5 Flare创作者内容、社交内容、产品体验、视觉搜索、快速原型、高批量生成 | 默认首选;质量优于 GPT-Image-2,延迟约降 50%
GPT-Image-2.5 Sunburst成品级营销创意、精修产品图、高精度编辑 | 编辑控制更精细;生成时间更长,换取更高精度
API 支持的分辨率:1024×1024、2048×2048 以及 3840×2160(4K 横版),最长边不超过 3840px,总像素数在 655,360 到 8,294,400 之间。
注意:GPT‑Image 2.5 与 “Luna‑Lisa‑Alpha” 目前均未获得 OpenAI 官方确认。本文基于公开测试线索与社区讨论撰写,请以官方公告为准。
近期,一则关于 OpenAI 图像模型的消息在 AI 圈引发讨论:据开发者 Pankaj Kumar 在 X 上分享的信息,一个名为 “Luna‑Lisa‑Alpha” 的匿名图像模型疑似正在 Arena 中测试,并可能与 GPT‑Image 的下一次迭代有关。
原帖:GPT-Image 2.5 Leaks: Luna-Lisa-Alpha
这是否意味着 GPT‑Image 2.5 即将发布?
目前还不能下结论。但从已流出的线索看,OpenAI 的图像生成能力可能正在朝着更高真实感、更干净画质与更稳定细节的方向推进。
“Luna‑Lisa‑Alpha” 是什么?
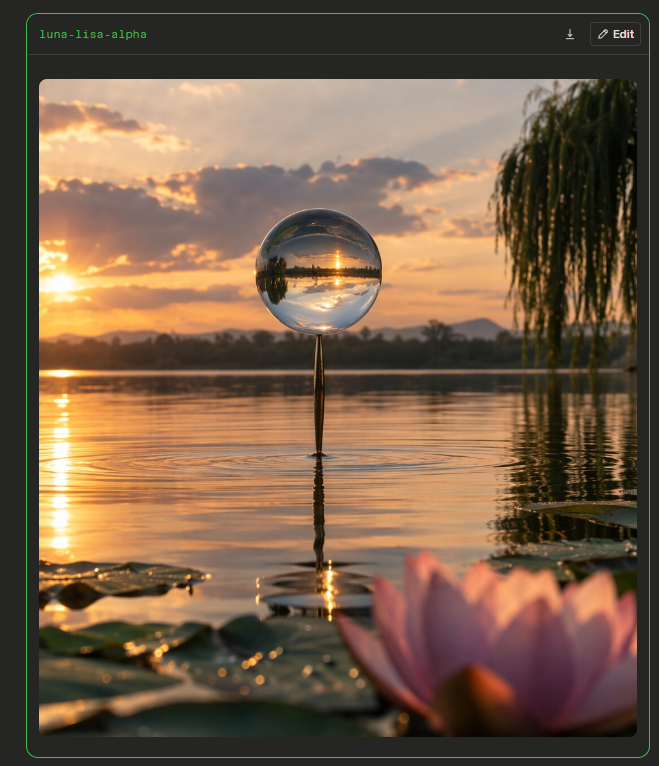
Arena 中出现了一个名为 luna-lisa-alpha 的新匿名 checkpoint。它被认为是此前 mona-lisa 测试模型的后续版本。
根据爆料,这个新模型可能有三项明显改进:
- 写实感更强,人物、材质和环境细节更自然;
- 整体图像质量有所提升;
- 先前版本中被提到的噪点、颗粒感问题明显减少甚至消失。
匿名测试模型通常不会直接说明最终产品名称,因此 “Luna‑Lisa‑Alpha” 可能只是内部或临时的测试代号,而非未来正式 API 或 ChatGPT 中的模型名称。
它会是 GPT‑Image 2.5,还是 GPT‑Image 3?
目前最值得关注的并不是版本号,而是能力方向。
如果该测试模型确实来自 OpenAI,GPT‑Image 的下一代升级很可能聚焦于“可用性”而不仅是“更好看”:更稳定的写实输出、更干净的画面、更少的颗粒噪声,以及更适合商业视觉生产的成片质量。
至于最终叫 GPT‑Image 2.5 还是 GPT‑Image 3,现在都只是社区推测。版本命名往往与产品节奏、API 兼容性和功能范围有关,不能仅凭匿名模型代号判断。
为什么“去噪”和“颗粒感改善”很重要?
在 AI 生图实际工作流中,噪点并不只是审美问题。
对于人像、品牌海报、电商产品图、室内设计图等需要高清交付的场景,过多的颗粒感会让画面显得不够干净,后期修图成本也会随之上升。尤其在暗部、皮肤、纯色背景和大面积渐变区域,模型产生的细微噪点往往会影响专业感。
当前 GPT-Image-2 就存在暗黑状态下的大量噪点,还需要借助其他模型进一步处理去噪。
如果下一代 GPT‑Image 能更好地控制这些问题,它的价值可能体现在:
- 更适合直接用于广告素材与社媒内容;
- 减少 Photoshop、放大和降噪的后期步骤;
- 提升产品展示图、人物肖像与品牌视觉的一致性;
- 让 AI 生成图更接近“可交付成品”,而非仅供灵感参考。
对创作者和开发者意味着什么?
对创作者而言,下一代图像模型的竞争重点,可能从“能不能生成”转向“能否稳定复现”。
一张惊艳图片并不难,难的是连续生成多个视角、多个版式、多个营销素材时,仍能保持人物、风格、文字和构图质量一致。
对开发者而言,值得重点观察的将包括:
- 文本渲染准确度是否继续提升;
- 图像编辑与局部重绘是否更可控;
- 多轮修改能否保留主体和构图;
- API 成本、生成速度和分辨率是否变化;
- 图像安全策略与商业使用边界是否调整。